

Enrutador LLM: Cómo funciona el enrutamiento de modelos y cuándo tu aplicación necesita uno
 Anna
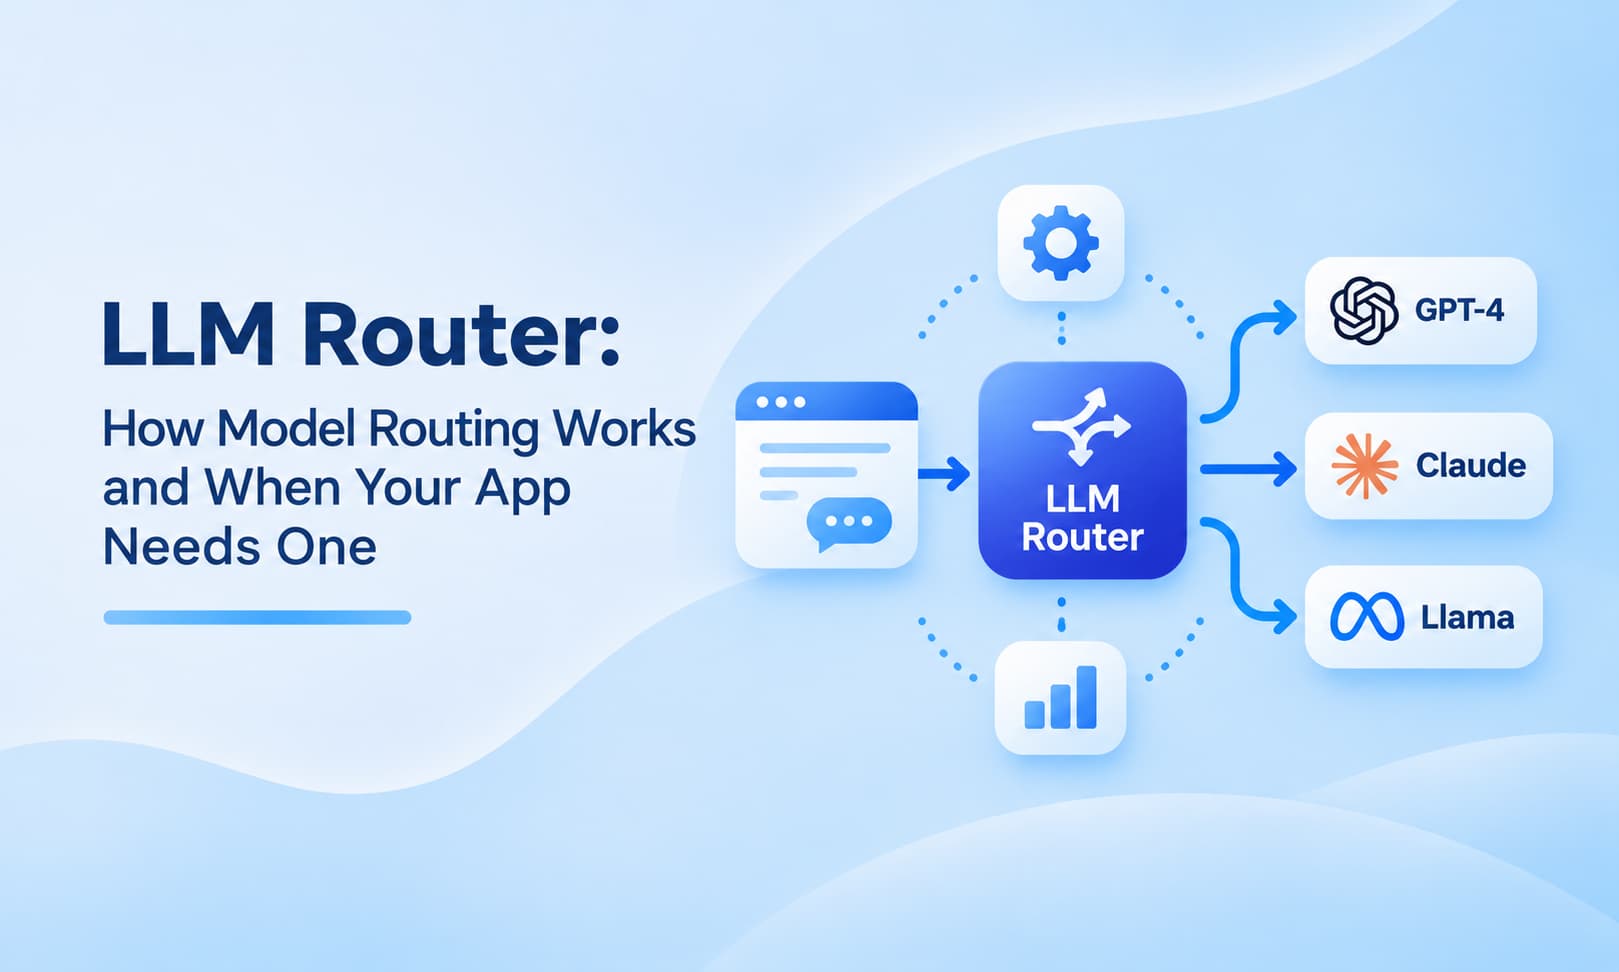
Tabla de contenidos:
Respuesta rápida: Un enrutador LLM se sitúa entre tu aplicación y tus proveedores de modelos y elige qué modelo responde cada solicitud. Las solicitudes simples van a modelos rápidos y baratos, las difíciles van a modelos más potentes, y las llamadas fallidas van a un proveedor de respaldo. Necesitas uno cuando usas varios modelos, experimentas interrupciones o límites de velocidad, o quieres reducir costos.
-
Estrategias principales: enrutamiento basado en reglas, semántico, basado en costo/complejidad, aprendido (p. ej. RouteLLM) y enrutamiento de respaldo.
-
Comienza simple: respaldo más algunas reglas cubre la mayoría de aplicaciones. Añade enrutamiento más inteligente cuando tus datos muestren una ganancia.
-
Compensaciones: un poco de latencia adicional, una dependencia más y datos que pasan a través de un tercero.
-
Mídelo: costo por 1,000 solicitudes, latencia p95, tasa de respaldo y verificaciones de calidad puntuales.
-
Configuración más rápida: una API compatible con OpenAI. Cambia la URL base y la clave, y mantén tu código.
La mayoría de equipos comienzan con un modelo para todo. Funciona hasta que la factura crece, un proveedor tiene una interrupción, o te das cuenta de que "¿Cuál es tu horario de atención?" va al mismo modelo costoso que "Revisa este contrato de 40 páginas".
Ningún modelo es la mejor opción para cada solicitud en costo, velocidad y calidad al mismo tiempo.
Esta guía explica qué hace un enrutador LLM, cómo se toman las decisiones de enrutamiento, las estrategias principales, qué te cuesta un enrutador y cómo saber si tu aplicación necesita uno todavía.
Qué es un enrutador LLM
Un enrutador LLM es software que se sitúa entre tu aplicación y uno o más proveedores de modelos. Tu aplicación envía una solicitud al enrutador una vez, y el enrutador elige qué modelo y qué proveedor debe responderla. Tu código ya no codifica "siempre llama al modelo X".
La función principal de un enrutador LLM se reduce a cuatro tareas:
-
Selección de modelo. Elige el modelo que se ajusta a la solicitud: un modelo pequeño y rápido para una clasificación breve, un modelo de razonamiento potente para análisis multietapa, un modelo de contexto largo para un documento grande.
-
Respaldo y conmutación por error. Cuando un proveedor devuelve un error, alcanza un límite de velocidad o se ralentiza, reintenta o envía la solicitud a otro lugar en lugar de fallar al usuario.
-
Equilibrio de carga. Distribuye el tráfico entre claves, regiones o proveedores para que ninguna cuota se convierta en el cuello de botella.
-
Control de costos. Mantén los modelos costosos para las solicitudes que realmente los necesitan.
Algunos equipos lo llaman enrutador de modelo de IA o enrutador de modelo.
💡 La idea es la misma: la decisión sobre qué modelo usar sale del código de tu aplicación y va a un lugar que puedes cambiar.
Enrutador LLM vs puerta de enlace LLM
Los dos términos se superponen, y muchos productos hacen ambos. La manera más simple de separarlos: un enrutador decide dónde va una solicitud; una puerta de enlace gestiona todo lo que rodea la solicitud.
| Enrutador LLM | Puerta de enlace LLM | |
|---|---|---|
| Pregunta principal que responde | ¿Qué modelo debe manejar esta solicitud? | ¿Cómo llegan todas las solicitudes a los proveedores de forma segura y consistente? |
| Características típicas | Selección de modelo, reglas de enrutamiento, respaldo, equilibrio de carga | Una API para muchos proveedores, claves API, cuotas, límites de velocidad, registro, facturación |
| ¿Puede existir sin el otro? | Sí, como algunas líneas de código en tu aplicación | Sí, como un proxy que solo reenvía solicitudes |
| En la práctica | Generalmente una característica dentro de una puerta de enlace | Generalmente incluye enrutamiento |
Si estás comparando productos, mira ambas mitades. Un enrutador con reglas inteligentes pero sin respaldo, registro o límites de gasto aún te deja construir el resto tú mismo.
Cómo funciona el enrutamiento LLM
El enrutamiento LLM es el proceso de decisión que un enrutador ejecuta en cada solicitud. Las implementaciones difieren, pero la mayoría sigue los mismos seis pasos:
-
Llega la solicitud. Tu aplicación envía un mensaje a un extremo, a menudo en el formato de solicitud de OpenAI, con pistas opcionales como un nombre de tarea, un nivel de usuario o un costo máximo.
-
El enrutador la clasifica. Lee las señales que tiene: longitud del mensaje, tipo de tarea, palabras clave, una incrustación del mensaje o una puntuación de un modelo pequeño entrenado que estima qué tan difícil es la solicitud.
-
Elige un objetivo. Según esa clasificación y tus reglas, selecciona un modelo y un proveedor, por ejemplo un modelo pequeño para una respuesta de preguntas frecuentes o un modelo de frontera para una tarea de codificación.
-
Llama al proveedor. La solicitud se traduce al formato de ese proveedor si es necesario y se envía.
-
Maneja el fallo. Si la llamada devuelve un error del servidor, un error de límite de velocidad 429 o tarda demasiado, el enrutador reintenta con retroceso o pasa al siguiente modelo en una lista de respaldo.
-
Registra el resultado. El modelo utilizado, tokens, costo y latencia se registran para que puedas ver si tus reglas de enrutamiento hacen lo que esperas.
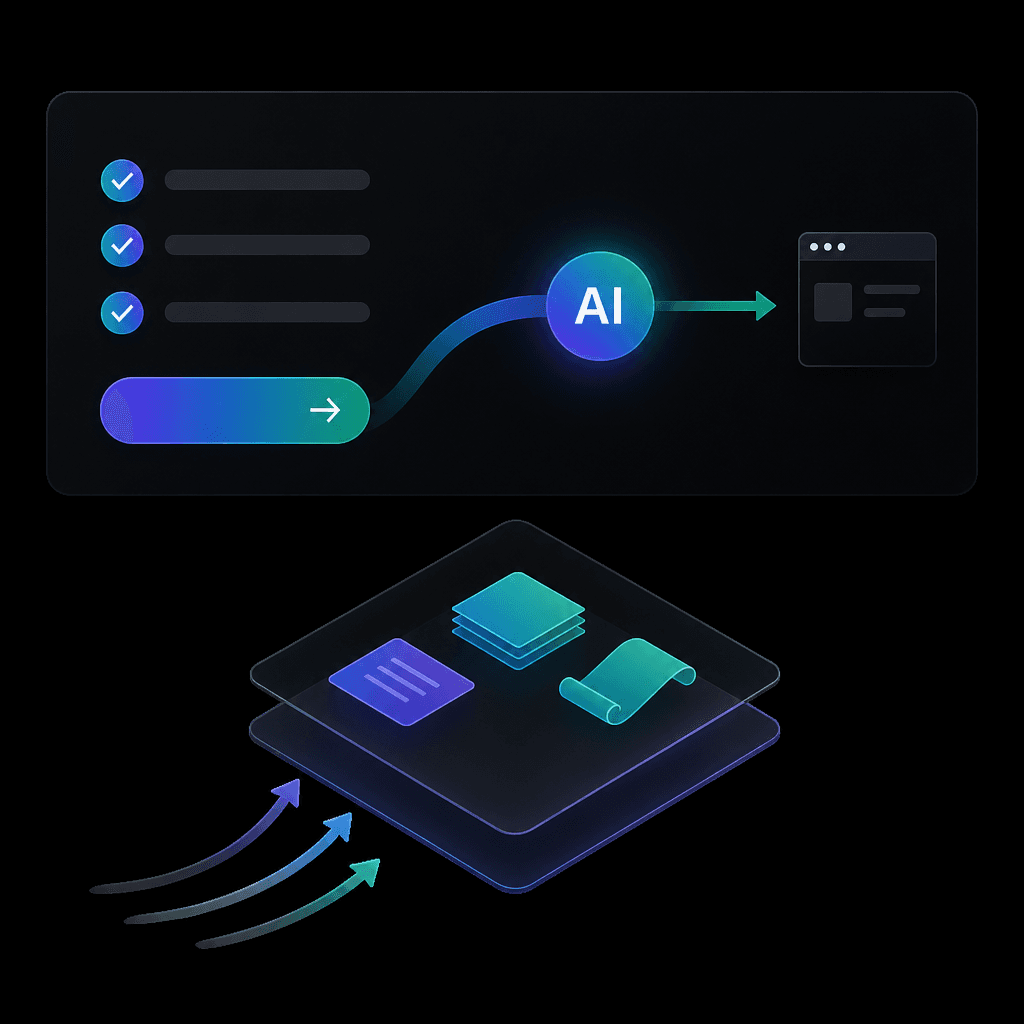
Una solicitud entra; el enrutador elige el modelo, cambia a un respaldo cuando una llamada falla, y registra cuánto costó cada solicitud.
Tu aplicación solo ve los pasos 1 y 6: una solicitud entra, una respuesta sale. Esa separación es la razón principal por la que los equipos adoptan el enrutamiento de modelos.
Puedes cambiar modelos, añadir proveedores o ajustar las reglas de costo sin enviar nuevo código de aplicación.
Estrategias de enrutamiento LLM
Hay cinco formas comunes en que un enrutador decide dónde va una solicitud. La mayoría de configuraciones de producción combinan dos o tres: reglas simples para los casos obvios, un método más inteligente para el resto, y respaldo debajo de todo.
| Estrategia | Cómo decide | Mejor para | Desventaja principal |
|---|---|---|---|
| Basada en reglas | Condiciones fijas: nombre de tarea, nivel de usuario, longitud del mensaje | Cargas de trabajo claras y predecibles | Las reglas se vuelven desordenadas y pierden casos extremos |
| Semántica | Compara la incrustación del mensaje con mensajes de ejemplo para cada ruta | Tráfico mixto con intenciones reconocibles | Necesita buenos ejemplos y un umbral de similitud ajustado |
| Costo / complejidad | Estima la dificultad, envía mensajes fáciles a modelos más baratos | Reducir gastos en aplicaciones de alto volumen | Una estimación incorrecta envía un mensaje difícil a un modelo débil |
| Aprendido | Un clasificador entrenado predice qué modelo responderá lo suficientemente bien | Grandes volúmenes con datos de calidad para entrenar | Datos de entrenamiento, evaluación y monitoreo de desviación |
| Respaldo / equilibrio de carga | Orden de preferencia más verificaciones de salud, cuotas y latencia | Protección de tiempo de actividad y límites de velocidad | No elige por calidad, solo por disponibilidad |
Enrutamiento basado en reglas
La técnica de enrutamiento LLM más simple:
Si la tarea es "summarize_ticket", usa el modelo A;
Si el usuario está en el plan gratuito, usa el modelo B;
Si el mensaje supera 50,000 tokens, usa un modelo de contexto largo.
Las reglas son rápidas, baratas de ejecutar y fáciles de depurar. Comienza aquí. La mayoría de aplicaciones obtienen una gran parte del beneficio de algunas reglas.
Enrutamiento semántico
El enrutador convierte cada mensaje entrante en una incrustación y lo compara con mensajes de ejemplo para cada ruta.
"¿Cuál es mi saldo?" y "¿Cuánto dinero tengo?" llegan a la misma ruta aunque no compartan palabras clave.
El enrutamiento semántico funciona bien para chatbots y asistentes de soporte donde los usuarios expresan la misma intención de muchas formas.
Necesitas un conjunto de ejemplos por ruta y un umbral de similitud, más una ruta predeterminada para mensajes que no coincidan con nada.
Enrutamiento basado en costo y complejidad
Aquí el enrutador estima qué tan difícil es una solicitud y la envía al modelo más barato que probablemente pueda manejarlo.
Los saludos, clasificaciones y respuestas breves de hechos van a un modelo pequeño; el razonamiento multietapa, código y análisis largo van a un modelo de frontera.
Esta es la estrategia detrás de la mayoría de reclamos "reduce tu factura de LLM", porque en muchas aplicaciones la mayoría de solicitudes son simples.
Enrutamiento aprendido (RouteLLM)
Los enrutadores aprendidos entrenan un modelo pequeño para predecir, para cada mensaje, si un modelo más barato responderá lo suficientemente bien. El ejemplo de código abierto más conocido es RouteLLM de LMSYS, que entrenó cuatro tipos de enrutador, incluyendo un modelo de factorización de matriz y un clasificador BERT.
Enrutando entre GPT-4 Turbo y Mixtral 8x7B, LMSYS reportó reducciones de costo de más del 85% en MT Bench, 45% en MMLU y 35% en GSM8K mientras mantenían el 95% del desempeño de GPT-4.
Esos son resultados de referencia de modelos de 2024, así que trátalos como evidencia de que el enfoque funciona, no como un pronóstico para tu tráfico.
Enrutamiento de respaldo y equilibrio de carga
Esta estrategia no juzga el mensaje en absoluto. Mantiene un orden preferido de modelos o proveedores y baja en la lista cuando una llamada falla: un error 5xx, una respuesta de límite de velocidad 429, un tiempo de espera agotado o un flujo que se interrumpe a mitad de la respuesta.
El equilibrio de carga distribuye las solicitudes entre varias claves o proveedores para que ninguna cuota se agote. Es la estrategia menos inteligente y a menudo la más valiosa, porque mantiene tu aplicación respondiendo durante una interrupción.
Si golpeas regularmente 429s, consulta nuestra guía sobre límites de velocidad de API de OpenAI.
¿Necesitas un enrutador LLM?
No todas las aplicaciones lo hacen. Un enrutador se paga cuando tienes opciones que elegir entre modelos o fallos que absorber. Si marques dos o más de estos, vale la pena configurar uno:
-
Ya llamas a dos o más modelos o proveedores, o planeas hacerlo.
-
Has alcanzado límites de velocidad, errores 429 o interrupciones de proveedores en producción.
-
Tu tráfico mezcla solicitudes simples (preguntas frecuentes, etiquetado, respuestas breves) con difíciles (razonamiento, código, documentos largos).
-
El gasto en modelos es un elemento de línea que alguien pregunta cada mes.
-
Quieres probar un nuevo modelo en parte de tu tráfico sin una versión de código.
-
Estás cansado de gestionar claves separadas, SDKs e facturas para cada proveedor.
Probablemente puedas esperar si usas un modelo, tu volumen es bajo, las interrupciones no afectarían a nadie y la factura no es una preocupación.
En ese caso, un SDK de un único proveedor es más simple, y añadir un enrutador temprano solo añade una pieza en movimiento.
Revisita la pregunta cuando cualquiera de las condiciones anteriores cambie.
También hay un camino intermedio. Apuntar tu aplicación a un extremo compatible con OpenAI que admita muchos modelos te cuesta casi nada hoy, porque mantienes el mismo SDK.
Cuando realmente necesites enrutamiento o respaldo más tarde, es un cambio de configuración en lugar de una migración.
Lo que un enrutador LLM te cuesta
Un enrutador resuelve problemas reales, pero no es gratuito. La mayoría de páginas de vendedores se omiten esta parte, así que aquí está claramente.
-
Latencia agregada. Cada solicitud toma un salto extra, y algunas estrategias añaden trabajo antes de la llamada: calcular una incrustación o ejecutar un clasificador. El enrutamiento basado en reglas añade muy poco; el enrutamiento aprendido y semántico añaden más. Los vendedores citan números muy diferentes de sobrecarga, así que mídelo tú mismo con tus propios mensajes y región. Para más información sobre qué impulsa el tiempo de respuesta, consulta nuestra guía sobre latencia de API.
-
Otra dependencia. Si el enrutador cae, todo lo que está detrás también cae. Verifica su registro de tiempo de actividad, página de estado y qué sucede con las solicitudes en vuelo durante un incidente.
-
Datos que pasan a través de un tercero. Con un enrutador alojado, tus mensajes y respuestas pasan a través de una compañía más. Lee su política de retención de datos y verifica dónde se procesan los datos, especialmente para datos regulados.
-
Enrutamientos incorrectos. Una estimación de complejidad a veces enviará un mensaje difícil a un modelo débil. Los usuarios notan una respuesta mala más que una lenta, así que comienza conservador y afloja las reglas conforme obtengas datos.
-
Salidas inconsistentes. Diferentes modelos formatean las respuestas de forma diferente. Si tu aplicación analiza JSON o espera una estructura fija, usa salidas estructuradas o valida respuestas, sea cual sea el modelo que respondió.
Cómo medir si el enrutamiento funciona
Un enrutador que no puedas medir es solo una conjetura con pasos extras. Antes de activarlo, registra una línea de base de tu configuración actual, luego compara los mismos números después.
| Métrica | Qué te dice | Ten cuidado con |
|---|---|---|
| Costo por 1,000 solicitudes | Si el enrutamiento está ahorrando dinero | Ahorros que vienen con una caída de calidad |
| Latencia p95 | La experiencia de cola lenta que los usuarios realmente sienten | Sobrecarga del enrutador o modelos de respaldo lentos |
| Porcentaje de tráfico por modelo | Si las reglas se comportan como se pretendía | Casi todo aún va al modelo costoso |
| Tasa de respaldo | Con qué frecuencia falla la opción principal | Una tasa creciente significa un problema de proveedor o cuota |
| Verificaciones de calidad puntuales | Si los modelos más baratos responden lo suficientemente bien | Calificaciones más bajas o más reintentos en solicitudes enrutadas |
Para calidad, muestrea algunas docenas de solicitudes enrutadas cada semana y revísalas, o ejecutalas también a través del modelo fuerte y compara.
Las tasas de pulgar hacia arriba, tasas de reintento y tickets de soporte son señales útiles también.
Implementa en pasos. Comienza solo con respaldo, añade dos o tres reglas simples, y pasa a enrutamiento semántico o aprendido solo cuando tus números muestren dónde están los ahorros restantes.
Tipos de enrutadores LLM
Cuando las personas buscan el mejor enrutador LLM, generalmente están eligiendo entre cuatro tipos de soluciones. La correcta depende de cuánto quieras construir y ejecutar tú mismo.
| Tipo | Ejemplos | Lo que obtienes | Lo que asumes |
|---|---|---|---|
| Construir el tuyo | Algunas reglas en tu código | Control total, sin vendedor extra | Cada SDK de proveedor, reintentos, registro y claves |
| Enrutador de código abierto | LiteLLM, RouteLLM, Enrutador LLM de NVIDIA | Lógica de enrutamiento lista que puedes autoalojar | Alojamiento, escalado, actualizaciones y monitoreo |
| Puerta de enlace alojada | OpenRouter, Portkey, Enrutador de modelo de Azure AI Foundry | Muchos modelos detrás de una API, sin servidores que ejecutar | Un vendedor en tu ruta de solicitud |
| API compatible con OpenAI con enrutamiento | ScriptRun | Enrutamiento, respaldo y una factura sin cambiar tu SDK | Un vendedor en tu ruta de solicitud |
Construir el tuyo tiene sentido para uno o dos modelos y reglas simples.
El código abierto se adapta a equipos con experiencia en infraestructura y requisitos de datos estrictos.
Una opción alojada se adapta a equipos que quieren que el enrutamiento funcione esta semana en lugar de este trimestre.
Para una comparación lado a lado de opciones alojadas, consulta nuestra comparación de alternativas de OpenRouter.
Enrutamiento con una API compatible con OpenAI
La forma más rápida de añadir enrutamiento a una aplicación existente es mantener el SDK que ya usas y cambiar dónde apunta.
Porque la mayoría de modelos ahora se pueden alcanzar a través del formato de solicitud de OpenAI, una API compatible con OpenAI te permite cambiar o enrutar entre modelos sin reescribir tu integración.
La API compatible con OpenAI de ScriptRun funciona así. Mantienes el SDK de OpenAI, cambias la base_url y la clave, y obtienes:
-
Múltiples proveedores de modelos detrás de una interfaz, sin cuentas separadas o KYC para cada proveedor
-
Enrutamiento inteligente que elige un modelo por calidad, costo y tamaño de contexto
-
Respaldo automático entre proveedores durante interrupciones
-
Reintentos con retroceso e idempotencia a nivel de solicitud, para que una llamada reintentada no se procese dos veces
-
Claves por proyecto, límites y cuotas, más una sola factura
Así es como se ve el cambio en Python:
from openai import OpenAI

client = OpenAI(
    base_url="SCRIPTRUN_BASE_URL",   # desde tu panel de ScriptRun
    api_key="YOUR_SCRIPTRUN_KEY",
)

response = client.chat.completions.create(
    model="MODEL_ID",               # cualquier modelo disponible en ScriptRun
    messages=[{"role": "user", "content": "Resume este ticket de soporte en dos líneas."}],
)
print(response.choices[0].message.content)
El resto de tu código, incluyendo streaming, herramientas e incrustaciones, permanece igual.
Si creces más que el enrutamiento simple más tarde, la API de Workflow de ScriptRun añade ramificación, condiciones, tiempos de espera y reintentos para tareas de IA multietapa.
Obtén una clave de API para probarla en tu propio tráfico.
Preguntas frecuentes sobre LLM Router
¿Qué es el enrutamiento de LLM?
El enrutamiento de LLM es el proceso de elegir qué modelo de lenguaje grande debe responder cada solicitud, basándose en reglas, el significado del indicador, su dificultad, objetivos de costo o salud del proveedor. El software que toma esta decisión se llama enrutador de LLM.
¿Agrega latencia un enrutador LLM?
Sí, un poco. Cada enrutador añade un salto de red, y el enrutamiento semántico o aprendido también añade un paso de clasificación. El enrutamiento basado en reglas añade lo menos. En la práctica, enrutar indicaciones simples a modelos más rápidos puede reducir el tiempo de respuesta promedio en general, pero mide la latencia p95 en tu propio tráfico antes y después.
¿Cuál es la diferencia entre un enrutador LLM y una puerta de enlace LLM?
Un enrutador decide qué modelo maneja una solicitud. Una puerta de enlace es la capa más amplia que te proporciona una API para muchos proveedores y maneja claves, cuotas, registro y facturación. La mayoría de las puertas de enlace incluyen un enrutador.
¿Cómo reduce el enrutamiento de modelos los costos de LLM?
Envía solicitudes que no requieren un modelo de frontera a modelos más económicos. Si una gran parte de tu tráfico es simple, como saludos, etiquetado o respuestas cortas, enrutar esas solicitudes a un modelo pequeño reduce la factura sin cambiar las respuestas a las preguntas difíciles.
¿Es un enrutador LLM mejor que llamar modelos directamente?
Para un modelo con poco tráfico, llamarlo directamente es más simple. Una vez que utilizas varios modelos, necesitas tiempo de actividad durante interrupciones del proveedor o deseas control sobre el gasto, un router te ahorra construir conmutación por error, reintentos y selección de modelo en tu propio código.
Publicaciones relacionadas
API de LLM más barata en 2026: precios verificados por cada 1 millón de tokens
¿Cuál es la API de LLM más barata? Precios verificados de OpenAI, Claude, Gemini, DeepSeek, Qwen, Mistral y Groq, además de costos reales de carga de trabajo y tarifas ocultas.
 Anna
Mercado de agentes de IA: los 10 mejores lugares para encontrar, ejecutar y vender agentes de IA en 2026
Qué es un marketplace de agentes de IA, una comparativa de 10 plataformas destacadas según el costo de prueba y quién puede vender, una lista de verificación de seguridad y cómo publicar tu propio agente en 2026.
Anna
API de LLM Gratuita: Qué Proveedores Siguen Siendo Gratuitos en 2026 (Límites, Claves y Trampas)
Cada API de LLM gratuita que vale la pena usar en 2026, verificada contra documentación oficial: niveles gratuitos vs créditos, límites, términos de datos, cómo obtener una clave y código de respaldo.
Anna
API Compatible con OpenAI: Qué es, Quién lo Soporta y Cómo Cambiar de Forma Segura
Una guía compatible con la API de OpenAI: URLs base para 15 proveedores, qué se rompe cuando cambias, una prueba de humo lista para copiar y pegar y una lista de verificación segura para la migración.
Anna