

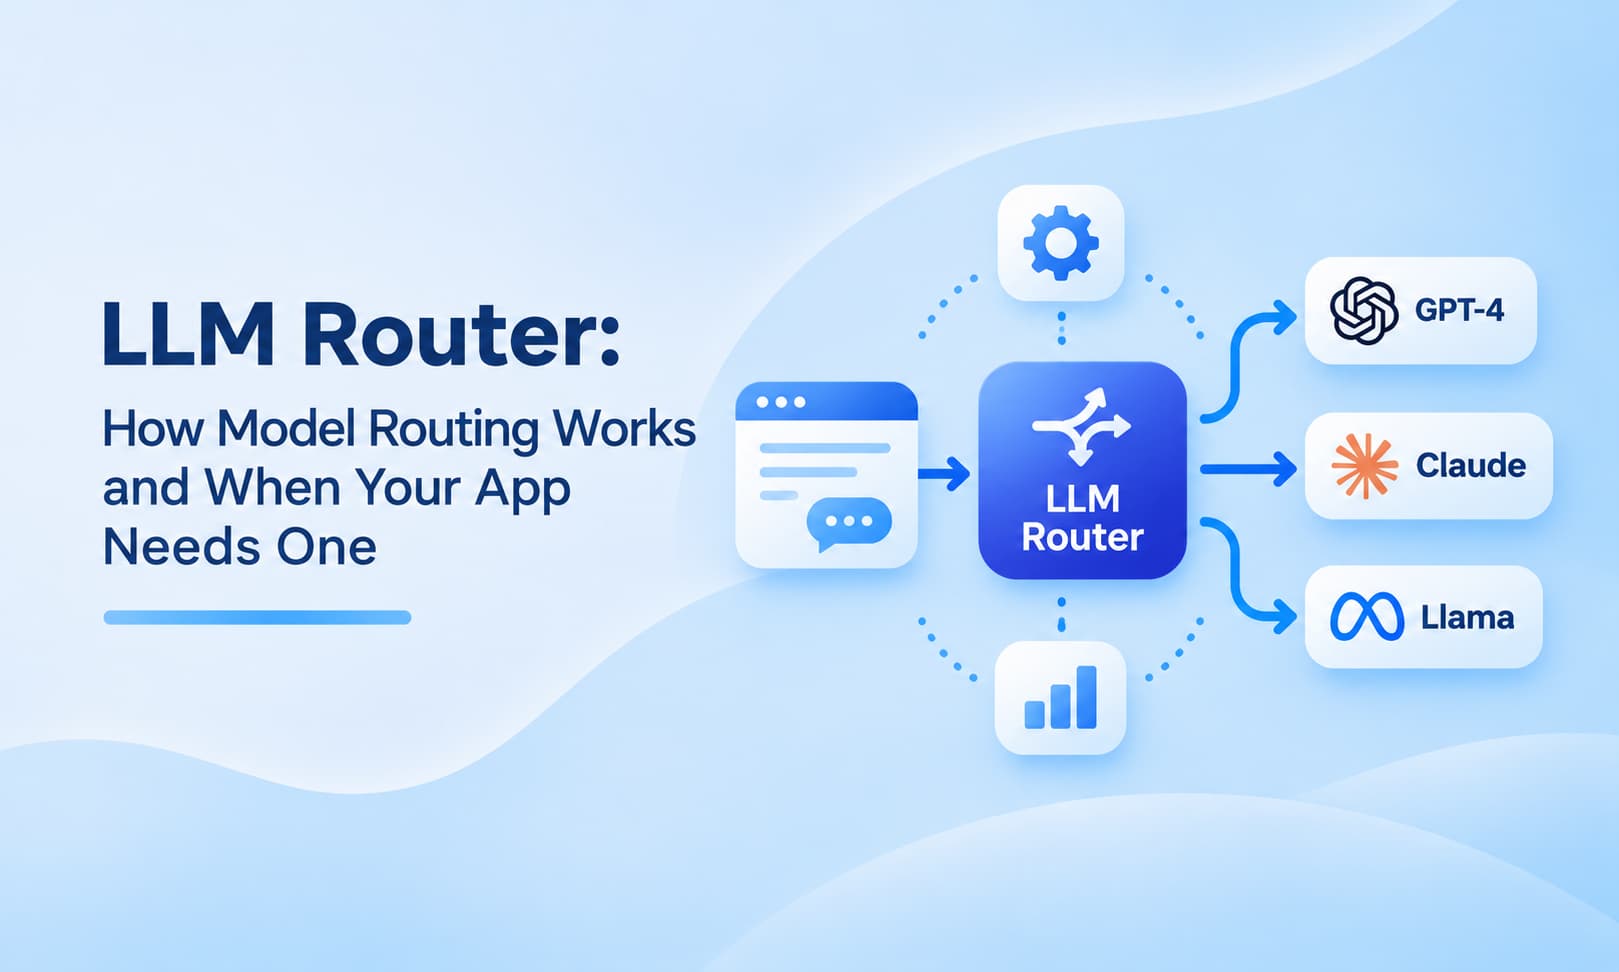
Roteador LLM: Como o Roteamento de Modelos Funciona e Quando Seu Aplicativo Precisa de Um
 Anna
Índice:
Resposta Rápida: Um roteador LLM fica entre seu aplicativo e seus provedores de modelo e escolhe qual modelo responde cada solicitação. Prompts simples vão para modelos rápidos e baratos, os difíceis vão para modelos mais fortes, e chamadas falhadas vão para um provedor de backup. Você precisa de um quando usa vários modelos, enfrenta interrupções ou limites de taxa, ou quer cortar custos.
-
Estratégias principais: roteamento baseado em regras, semântico, baseado em custo/complexidade, aprendido (p. ex. RouteLLM) e fallback.
-
Comece simples: fallback mais algumas regras cobre a maioria dos aplicativos. Adicione roteamento mais inteligente quando seus dados mostrarem um ganho.
-
Trade-offs: uma latência ligeiramente adicionada, uma dependência a mais, e dados passando por terceiros.
-
Meça-o: custo por 1.000 solicitações, latência p95, taxa de fallback e verificações pontuais de qualidade.
-
Configuração mais rápida: uma API compatível com OpenAI. Mude a URL base e a chave, e mantenha seu código.
A maioria das equipes começa com um modelo para tudo. Funciona até a conta crescer, um provedor ter uma interrupção, ou você notar que "Quais são seus horários de funcionamento?" está indo para o mesmo modelo caro que "Revise este contrato de 40 páginas."
Nenhum modelo único é a melhor escolha para cada solicitação em custo, velocidade e qualidade ao mesmo tempo.
Este guia explica o que um roteador LLM faz, como as decisões de roteamento são tomadas, as estratégias principais, quanto um roteador custa, e como saber se seu aplicativo já precisa de um.
O que é um roteador LLM
Um roteador LLM é um software que fica entre seu aplicativo e um ou mais provedores de modelo. Seu aplicativo envia uma solicitação ao roteador uma vez, e o roteador escolhe qual modelo e qual provedor deve respondê-la. Seu código não codifica mais "sempre chame o modelo X".
A função central de um roteador LLM se resume a quatro tarefas:
-
Seleção de modelo. Escolha o modelo que se ajusta à solicitação: um modelo pequeno e rápido para uma classificação curta, um modelo de raciocínio forte para análise multi-etapa, um modelo de contexto longo para um documento grande.
-
Fallback e failover. Quando um provedor retorna um erro, atinge um limite de taxa ou desacelera, tente novamente ou envie a solicitação para outro lugar em vez de falhar o usuário.
-
Balanceamento de carga. Distribua o tráfego entre chaves, regiões ou provedores para que nenhuma cota única se torne o gargalo.
-
Controle de custos. Mantenha modelos caros para as solicitações que realmente precisam deles.
Algumas equipes chamam isso de roteador de modelo de IA ou roteador de modelo.
💡 A ideia é a mesma: a decisão sobre qual modelo usar sai do código do seu aplicativo e vai para um lugar que você pode mudar.
Roteador LLM vs Gateway LLM
Os dois termos se sobrepõem, e muitos produtos fazem os dois. A forma mais simples de separá-los: um roteador decide para onde uma solicitação vai; um gateway gerencia tudo em torno da solicitação.
| Roteador LLM | Gateway LLM | |
|---|---|---|
| Pergunta principal que responde | Qual modelo deve lidar com essa solicitação? | Como todas as solicitações chegam aos provedores com segurança e consistência? |
| Recursos típicos | Seleção de modelo, regras de roteamento, fallback, balanceamento de carga | Uma API para muitos provedores, chaves de API, cotas, limites de taxa, logging, faturamento |
| Pode existir sem o outro? | Sim, como algumas linhas de código no seu aplicativo | Sim, como um proxy que apenas encaminha solicitações |
| Na prática | Geralmente um recurso dentro de um gateway | Geralmente inclui roteamento |
Se você está comparando produtos, observe ambas as metades. Um roteador com regras inteligentes mas sem failover, logging ou limites de gastos ainda deixa você construindo o resto sozinho.
Como funciona o roteamento LLM
O roteamento LLM é o processo de decisão que um roteador executa em cada solicitação. As implementações diferem, mas a maioria segue os mesmos seis passos:
-
A solicitação chega. Seu aplicativo envia um prompt para um endpoint, geralmente no formato de solicitação OpenAI, com dicas opcionais como um nome de tarefa, um nível de usuário ou um custo máximo.
-
O roteador a classifica. Ele lê os sinais que possui: comprimento do prompt, tipo de tarefa, palavras-chave, um embedding do prompt, ou uma pontuação de um pequeno modelo treinado que estima o quão difícil é a solicitação.
-
Ele escolhe um alvo. Com base nessa classificação e em suas regras, seleciona um modelo e um provedor, por exemplo um modelo pequeno para uma resposta de FAQ curta ou um modelo de fronteira para uma tarefa de codificação.
-
Ele chama o provedor. A solicitação é traduzida para o formato desse provedor se necessário e enviada.
-
Ele lida com a falha. Se a chamada retornar um erro de servidor, um erro de limite de taxa 429 ou levar muito tempo, o roteador tenta novamente com backoff ou passa para o próximo modelo em uma lista de fallback.
-
Ele registra o resultado. Modelo usado, tokens, custo e latência são registrados, para que você possa ver se suas regras de roteamento estão fazendo o que você espera.
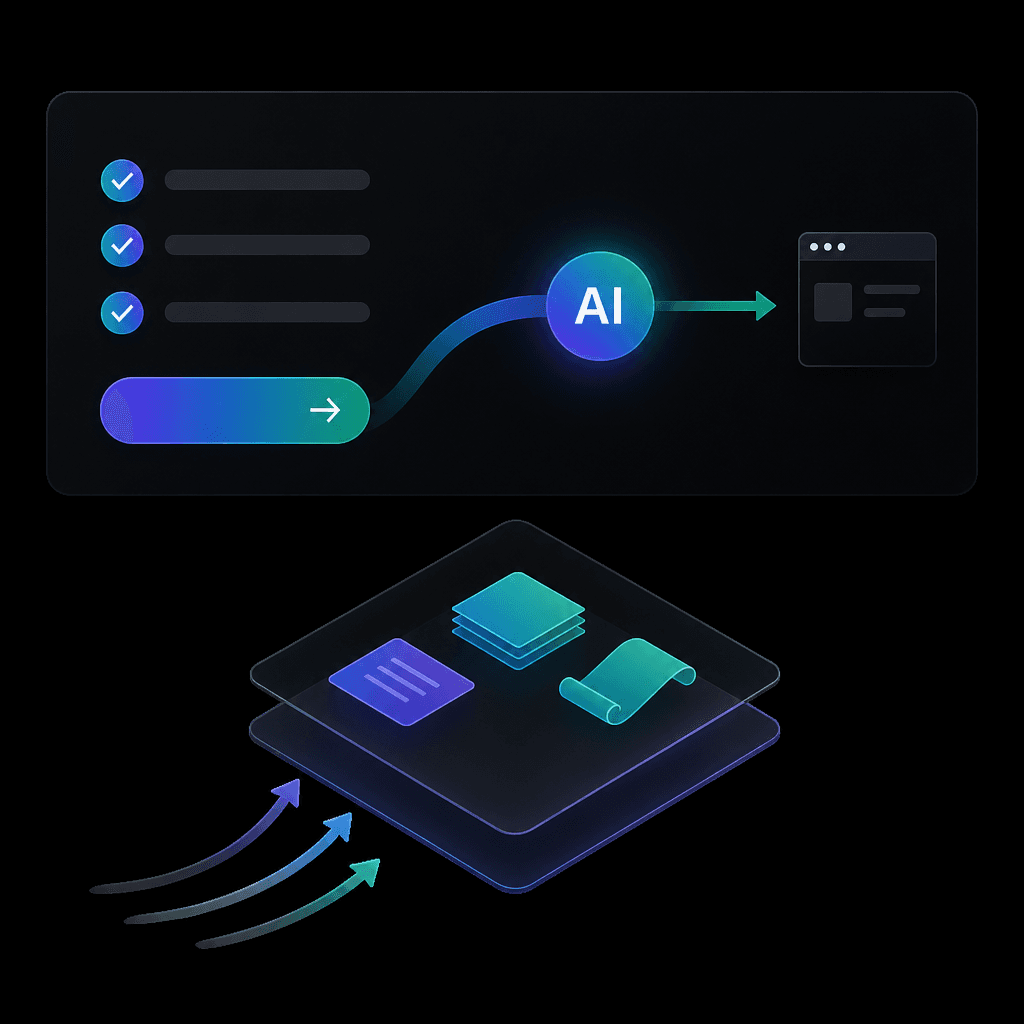
Uma solicitação entra; o roteador escolhe o modelo, muda para um backup quando uma chamada falha, e registra quanto cada solicitação custou.
Seu aplicativo vê apenas as etapas 1 e 6: uma solicitação dentro, uma resposta para fora. Essa separação é a razão principal pela qual as equipes adotam roteamento de modelo.
Você pode mudar modelos, adicionar provedores ou apertar regras de custo sem enviar novo código de aplicação.
Estratégias de roteamento LLM
Existem cinco maneiras comuns de um roteador decidir para onde uma solicitação vai. A maioria das configurações de produção combina duas ou três: regras simples para os casos óbvios, um método mais inteligente para o resto, e fallback sob tudo.
| Estratégia | Como decide | Melhor para | Desvantagem principal |
|---|---|---|---|
| Baseada em regras | Condições fixas: nome da tarefa, nível de usuário, comprimento do prompt | Cargas de trabalho claras e previsíveis | Regras ficam confusas e perdem casos extremos |
| Semântica | Compara o embedding do prompt com prompts de exemplo para cada rota | Tráfego misto com intenções reconhecíveis | Precisa de bons exemplos e um limiar de similaridade ajustado |
| Custo / complexidade | Estima dificuldade, envia prompts fáceis para modelos mais baratos | Cortar gastos em aplicativos de alto volume | Uma estimativa errada envia um prompt difícil para um modelo fraco |
| Aprendido | Um classificador treinado prevê qual modelo responderá bem o suficiente | Grandes volumes com dados de qualidade para treinar | Dados de treinamento, avaliação e monitoramento de desvio |
| Fallback / balanceamento de carga | Ordem de preferência mais verificações de saúde, cotas e latência | Uptime e proteção de limite de taxa | Não escolhe por qualidade, apenas por disponibilidade |
Roteamento baseado em regras
A técnica de roteamento LLM mais simples:
Se a tarefa é "summarize_ticket", use o modelo A;
Se o usuário está no plano gratuito, use o modelo B;
Se o prompt tem mais de 50.000 tokens, use um modelo de contexto longo.
As regras são rápidas, baratas de executar e fáceis de depurar. Comece aqui. A maioria dos aplicativos obtém uma grande parcela do benefício de um punhado de regras.
Roteamento semântico
O roteador transforma cada prompt recebido em um embedding e o compara com prompts de exemplo para cada rota.
"Qual é meu saldo?" e "Quanto dinheiro eu tenho?" vão para a mesma rota mesmo que não compartilhem palavras-chave.
O roteamento semântico funciona bem para chatbots e assistentes de suporte onde os usuários expressam a mesma intenção de muitas formas.
Você precisa de um conjunto de exemplos por rota e um limiar de similaridade, mais uma rota padrão para prompts que não correspondem a nada.
Roteamento baseado em custo e complexidade
Aqui o roteador estima o quão difícil é uma solicitação e a envia para o modelo mais barato provavelmente capaz de lidar com ela.
Saudações, classificações e respostas factuais curtas vão para um modelo pequeno; raciocínio multi-etapa, código e análise longa vão para um modelo de fronteira.
Esta é a estratégia por trás da maioria das reivindicações "corte sua conta de LLM", porque em muitos aplicativos a maioria das solicitações são simples.
Roteamento aprendido (RouteLLM)
Roteadores aprendidos treinam um pequeno modelo para prever, para cada prompt, se um modelo mais barato responderá bem o suficiente. O exemplo de código aberto mais conhecido é RouteLLM do LMSYS, que treinou quatro tipos de roteadores, incluindo um modelo de fatoração de matriz e um classificador BERT.
Roteando entre GPT-4 Turbo e Mixtral 8x7B, o LMSYS relatou reduções de custo de mais de 85% no MT Bench, 45% no MMLU e 35% no GSM8K mantendo 95% do desempenho do GPT-4.
Esses são resultados de benchmark de modelos de 2024, então trate-os como evidência de que a abordagem funciona, não como uma previsão para seu tráfego.
Roteamento de fallback e balanceamento de carga
Esta estratégia não julga o prompt. Mantém uma ordem preferida de modelos ou provedores e desce a lista quando uma chamada falha: um erro 5xx, uma resposta de limite de taxa 429, um tempo limite ou um stream que cai no meio de uma resposta.
O balanceamento de carga distribui solicitações entre várias chaves ou provedores para que nenhuma cota única se esgote. É a estratégia menos inteligente e muitas vezes a mais valiosa, porque mantém seu aplicativo respondendo durante uma interrupção.
Se você atinge 429s regularmente, veja nosso guia sobre limites de taxa da API OpenAI.
Você precisa de um roteador LLM
Nem todo aplicativo precisa. Um roteador compensa quando você tem escolhas a fazer entre modelos, ou falhas a absorver. Se você marca dois ou mais destes, vale a pena configurar um:
-
Você já chama dois ou mais modelos ou provedores, ou planeja.
-
Você atingiu limites de taxa, erros 429 ou interrupções de provedor em produção.
-
Seu tráfego mistura solicitações simples (FAQs, marcação, respostas curtas) com difíceis (raciocínio, código, documentos longos).
-
O gasto em modelo é um item de linha que alguém pergunta a cada mês.
-
Você quer testar um novo modelo em parte do seu tráfego sem uma versão de código.
-
Você está cansado de gerenciar chaves, SDKs e faturas separados para cada provedor.
Você provavelmente pode esperar se usar um modelo, seu volume é baixo, interrupções não prejudicariam ninguém, e a conta não é uma preocupação.
Nesse caso, um SDK de um único provedor é mais simples, e adicionar um roteador cedo apenas adiciona uma peça móvel.
Revise a questão quando qualquer uma das condições acima mudar.
Há também um caminho intermediário. Apontar seu aplicativo para um endpoint compatível com OpenAI que suporta muitos modelos custa quase nada hoje, porque você mantém o mesmo SDK.
Quando você realmente precisar de roteamento ou failover depois, é uma mudança de configuração em vez de uma migração.
O que um roteador LLM custa para você
Um roteador resolve problemas reais, mas não é de graça. A maioria das páginas de fornecedores pula esta parte, então aqui está de forma clara.
-
Latência adicionada. Cada solicitação leva um salto extra, e algumas estratégias adicionam trabalho antes da chamada: computar um embedding ou executar um classificador. O roteamento baseado em regras adiciona muito pouco; roteamento aprendido e semântico adiciona mais. Os fornecedores citam números de overhead muito diferentes, então meça você mesmo com seus próprios prompts e região. Para informações básicas sobre o que orienta o tempo de resposta, veja nosso guia sobre latência de API.
-
Outra dependência. Se o roteador ficar inativo, tudo atrás dele fica inativo também. Verifique seu registro de uptime, página de status e o que acontece às solicitações em trânsito durante um incidente.
-
Dados passando por terceiros. Com um roteador hospedado, seus prompts e respostas passam por uma empresa a mais. Leia sua política de retenção de dados e verifique onde os dados são processados, especialmente para dados regulados.
-
Roteamento incorreto. Uma estimativa de complexidade às vezes enviará um prompt difícil para um modelo fraco. Os usuários notam uma resposta ruim mais que uma lenta, então comece conservador e afrouxe as regras conforme ganha dados.
-
Saídas inconsistentes. Modelos diferentes formatam respostas diferentemente. Se seu aplicativo analisa JSON ou espera uma estrutura fixa, use saídas estruturadas ou valide respostas, qualquer que seja o modelo que respondeu.
Como medir se o roteamento funciona
Um roteador que você não pode medir é apenas um palpite com passos extras. Antes de ativá-lo, registre uma linha de base da sua configuração atual, depois compare os mesmos números depois.
| Métrica | O que diz | Fique atento a |
|---|---|---|
| Custo por 1.000 solicitações | Se o roteamento está economizando dinheiro | Economias que vêm com uma queda de qualidade |
| Latência p95 | A experiência de cauda lenta que os usuários realmente sentem | Overhead do roteador ou modelos de fallback lento |
| Compartilhamento de tráfego por modelo | Se as regras se comportam conforme pretendido | Quase tudo ainda indo para o modelo caro |
| Taxa de fallback | Com que frequência a escolha primária falha | Uma taxa crescente significa um problema de provedor ou cota |
| Verificações pontuais de qualidade | Se modelos mais baratos respondem bem o suficiente | Classificações mais baixas ou mais tentativas em solicitações roteadas |
Para qualidade, faça amostra de algumas dezenas de solicitações roteadas cada semana e revise-as, ou execute-as também no modelo forte e compare.
Taxas de polegar para cima, taxas de tentativa e tickets de suporte também são sinais úteis.
Implante em etapas. Comece apenas com fallback, adicione duas ou três regras simples, e mude para roteamento semântico ou aprendido apenas quando seus números mostrarem onde estão as economias restantes.
Tipos de roteadores LLM
Quando as pessoas pesquisam o melhor roteador LLM, elas geralmente escolhem entre quatro tipos de soluções. A certa depende de quanto você quer construir e executar você mesmo.
| Tipo | Exemplos | O que você obtém | O que você assume |
|---|---|---|---|
| Construa você mesmo | Algumas regras no seu código | Controle total, sem fornecedor extra | Cada SDK de provedor, tentativas, logging e chaves |
| Roteador de código aberto | LiteLLM, RouteLLM, NVIDIA LLM Router | Lógica de roteamento pronta que você pode auto-hospedar | Hospedagem, escalabilidade, atualizações e monitoramento |
| Gateway hospedado | OpenRouter, Portkey, Roteador de modelo do Azure AI Foundry | Muitos modelos atrás de uma API, sem servidores para executar | Um fornecedor em seu caminho de solicitação |
| API compatível com OpenAI com roteamento | ScriptRun | Roteamento, failover e uma conta sem mudar seu SDK | Um fornecedor em seu caminho de solicitação |
Construir o seu próprio faz sentido para um ou dois modelos e regras simples.
Código aberto se adequa a equipes com experiência em infraestrutura e requisitos rigorosos de dados.
Uma opção hospedada se adequa a equipes que querem roteamento funcionando esta semana em vez de este trimestre.
Para um lado a lado das opções hospedadas, veja nossa comparação de alternativas do OpenRouter.
Roteamento com uma API compatível com OpenAI
A forma mais rápida de adicionar roteamento a um aplicativo existente é manter o SDK que você já usa e mudar para onde ele aponta.
Como a maioria dos modelos agora pode ser acessada através do formato de solicitação OpenAI, uma API compatível com OpenAI permite que você mude ou roteie entre modelos sem reescrever sua integração.
A API compatível com OpenAI do ScriptRun funciona assim. Você mantém o SDK OpenAI, muda a base_url e a chave, e obtém:
-
Múltiplos provedores de modelo por trás de uma interface, sem contas separadas ou KYC para cada provedor
-
Roteamento inteligente que escolhe um modelo por qualidade, custo e tamanho de contexto
-
Failover automático entre provedores durante interrupções
-
Tentativas com backoff e idempotência no nível de solicitação, então uma chamada retentada não é processada duas vezes
-
Chaves por projeto, limites e cotas, mais uma conta única
Aqui está como a mudança fica em Python:
from openai import OpenAI

client = OpenAI(
    base_url="SCRIPTRUN_BASE_URL",   # do seu painel ScriptRun
    api_key="YOUR_SCRIPTRUN_KEY",
)

response = client.chat.completions.create(
    model="MODEL_ID",               # qualquer modelo disponível no ScriptRun
    messages=[{"role": "user", "content": "Resuma este ticket de suporte em duas linhas."}],
)
print(response.choices[0].message.content)
O resto do seu código, incluindo streaming, ferramentas e embeddings, permanece o mesmo.
Se você crescer além do roteamento simples depois, a API de Workflow do ScriptRun adiciona ramificação, condições, tempos limite e tentativas para tarefas de IA multi-etapa.
Obtenha uma chave de API para experimentar no seu próprio tráfego.
Perguntas Frequentes sobre LLM Router
O que é roteamento de LLM?
O roteamento de LLM é o processo de escolher qual modelo de linguagem grande deve responder a cada solicitação, com base em regras, no significado do prompt, sua dificuldade, objetivos de custo ou saúde do provedor. O software que faz essa escolha é chamado de roteador de LLM.
Um roteador LLM adiciona latência?
Sim, um pouco. Todo roteador adiciona um salto de rede, e o roteamento semântico ou baseado em aprendizado também adiciona uma etapa de classificação. O roteamento baseado em regras adiciona o mínimo. Na prática, rotear prompts simples para modelos mais rápidos pode reduzir o tempo médio de resposta geral, mas meça a latência p95 no seu próprio tráfego antes e depois.
Qual é a diferença entre um roteador LLM e um gateway LLM?
Um roteador decide qual modelo processa uma solicitação. Um gateway é a camada mais ampla que oferece uma API única para muitos provedores e gerencia chaves, quotas, registros e cobrança. A maioria dos gateways inclui um roteador.
Como o roteamento de modelos reduz custos de LLM?
Envia solicitações que não precisam de um modelo de fronteira para modelos mais baratos. Se uma grande parte do seu tráfego é simples, como saudações, marcação ou respostas curtas, rotear essas solicitações para um modelo pequeno reduz a conta sem alterar as respostas para as difíceis.
Um roteador de LLM é melhor do que chamar modelos diretamente?
Para um modelo com pouco tráfego, chamá-lo diretamente é mais simples. Uma vez que você usa vários modelos, precisa de disponibilidade durante interrupções do provedor ou quer controlar gastos, um roteador o poupa de construir fallback, tentativas e seleção de modelo em seu próprio código.
Publicações relacionadas
API de LLM mais barata em 2026: preços verificados por 1 milhão de tokens
Qual é a API de LLM mais barata? Preços verificados da OpenAI, Claude, Gemini, DeepSeek, Qwen, Mistral e Groq, além de custos reais de carga de trabalho e taxas ocultas.
 Anna
Marketplace de Agentes de IA: os 10 melhores lugares para encontrar, executar e vender agentes de IA em 2026
O que é um marketplace de agentes de IA, 10 principais plataformas comparadas por custo para testar e quem pode vender, uma lista de verificação de segurança e como listar o seu próprio agente em 2026.
Anna
API LLM Gratuita: Quais Provedores Ainda São Gratuitos em 2026 (Limites, Chaves e Pegadinhas)
Cada API LLM gratuita que vale a pena usar em 2026, verificada contra documentação oficial: camadas gratuitas versus créditos, limites, termos de dados, como obter uma chave e código de fallback.
Anna
API Compatível com OpenAI: O Que É, Quem Suporta e Como Mudar com Segurança
Um guia de API compatível com OpenAI: URLs base para 15 provedores, o que quebra quando você muda, um teste de fumaça pronto para copiar e colar e uma lista de verificação de migração segura.
Anna